从“翻不到”到“搜得准”:冷门CP的查找困境
站内同人区的默认排序和热门推荐几乎被几个大热CP占据,冷门CP的作品往往沉在很深的位置。读者小A喜欢的是《星轨余烬》里一对互动不多但很有张力的配角组合,用CP名直接搜,结果只有零星几篇,还夹杂着无关内容。常规浏览翻了几十页,收获几乎为零。
问题不在于站内没有内容,而在于入口不对。热门CP靠CP名就能命中,冷门CP则需要先锁定原作圈子,再用标签交叉把范围压到足够小。小A决定换一种方式:不再从CP名出发,而是从原作标签和CP标签的组合入手,配合形式与分级筛选,把“大海捞针”变成“按图索骥”。
第一步:原作标签与CP标签交叉,把范围压到最小
小A先打开《星轨余烬》的原作标签页,确认站内收录的同人作品总量和常用角色标签。他发现原作标签下还有细分:按角色、按关系、按结局倾向。冷门CP的两位角色各自有独立标签,但组合标签的收录量很少,单独搜组合标签只能得到个位数结果。
于是他把搜索条件改成“原作标签 + 角色A标签 + 角色B标签”三者同时满足,而不是只搜CP组合名。这样虽然会漏掉一些只打了CP名没打角色标签的作品,但能先把最核心的一批捞出来。交叉之后,结果从原来的几十页缩到三页以内,而且每一篇都确实涉及这对角色。
这一步的关键是接受“先窄后宽”:先用最严格的交叉条件锁定核心作品,再逐步放宽。小A把这三页结果全部标记为待读,作为后续筛选的底本。
第二步:按形式筛选,把“能看的”和“想看的”分开
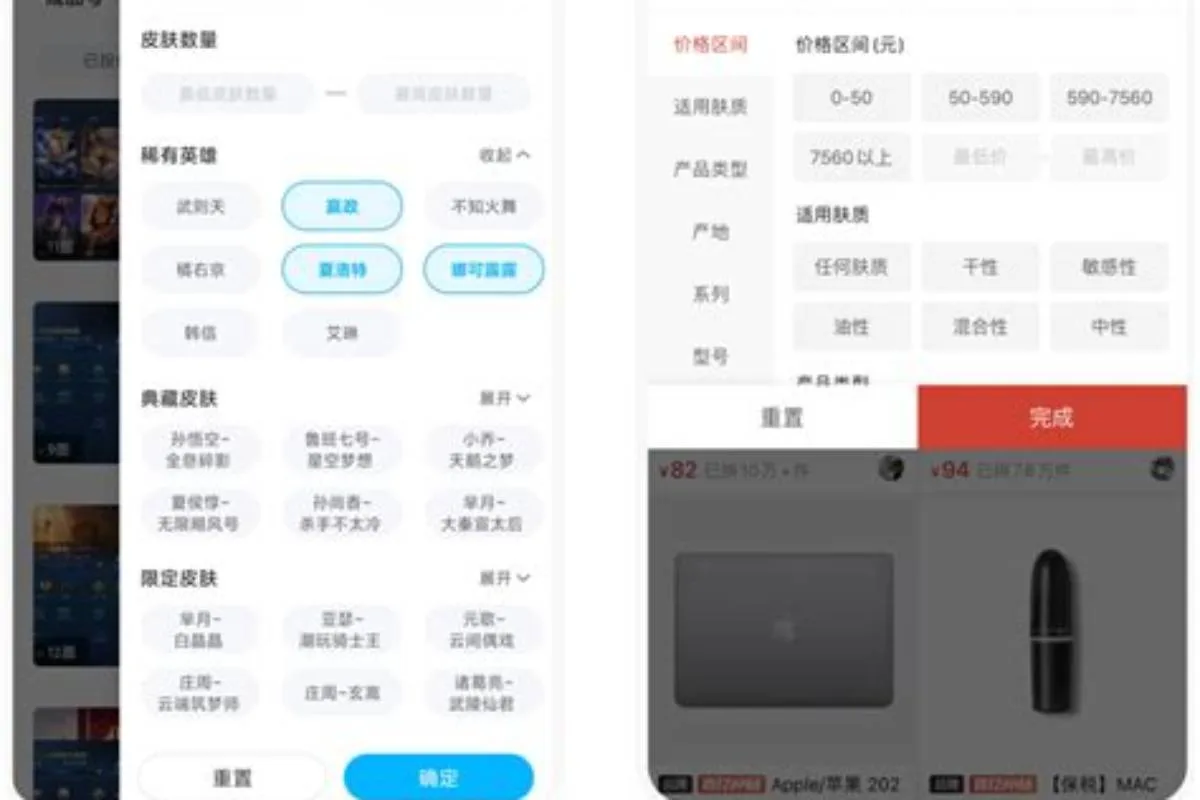
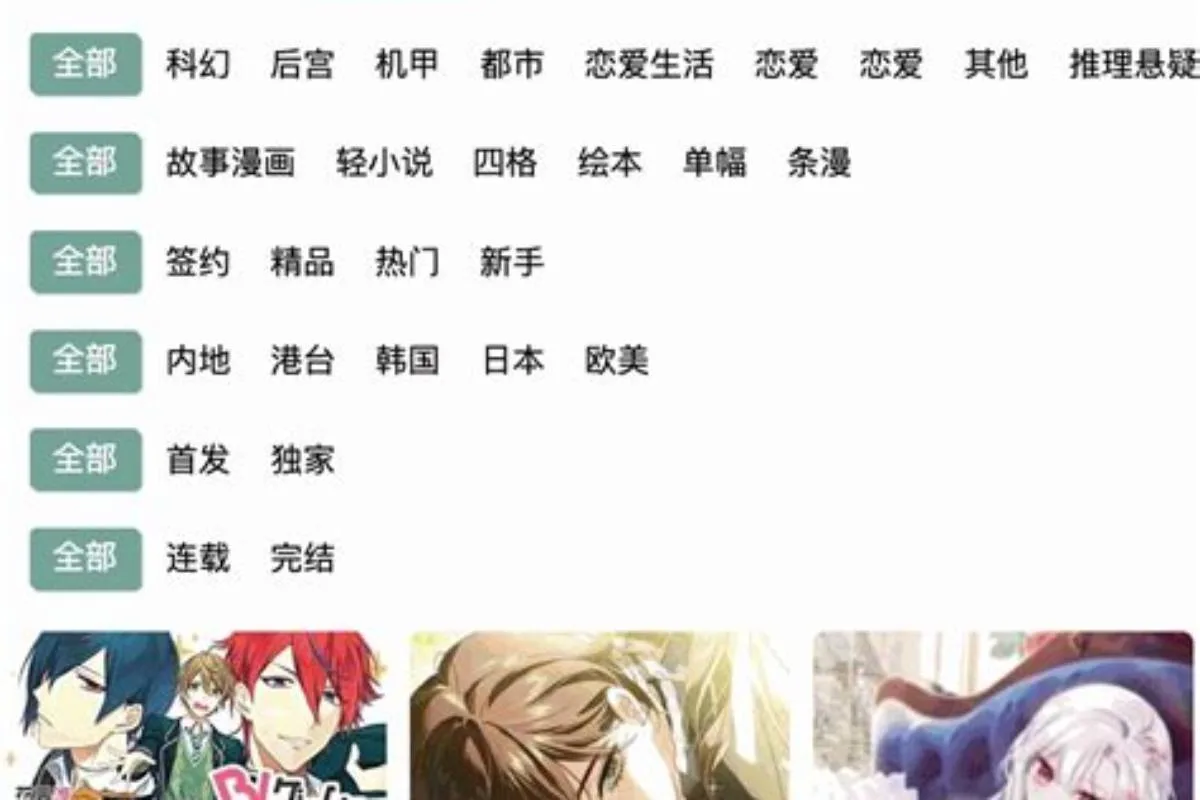
三页结果里形式很杂:有短篇、有连载、有图文合集、还有纯文字大纲。小A平时只看完结短篇和已完结连载,于是他在结果页勾选“短篇”和“连载-已完结”,把未完结和纯大纲先排除。这一步又去掉将近一半。
形式筛选之后,他注意到剩下的作品里有一部分是“段子合集”或“脑洞记录”,篇幅很短但信息密度低。他进一步用“字数大于三千”作为辅助条件,把太碎的条目过滤掉。站内虽然没有直接的排序按钮,但可以在结果里按字数手动扫一遍,几分钟就能完成。
经过形式筛选,底本从三页缩到一页半左右,剩下的都是结构完整、可以一口气读完的作品。小A说,这一步的意义不是找“最好的”,而是先保证“能读下去”,把选择成本降下来。
第三步:排除不感兴趣的分级,守住阅读舒适区
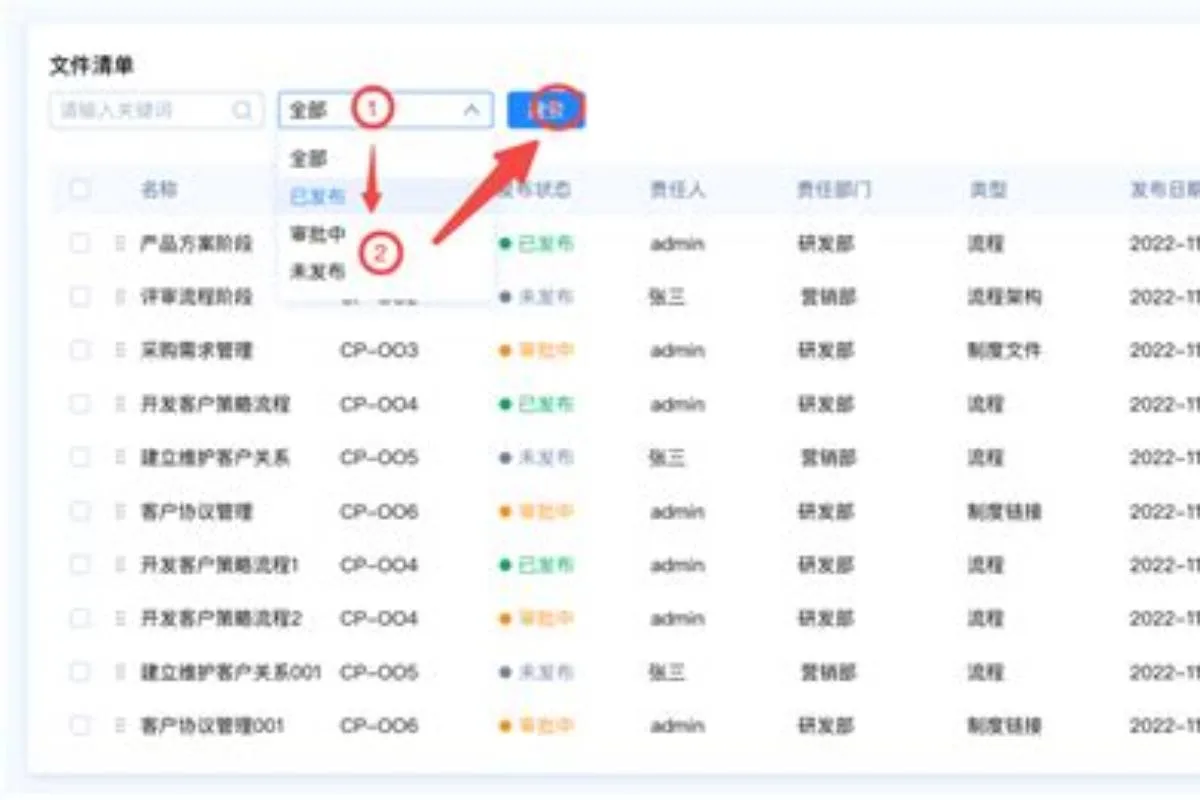
剩下的一页半里,分级标识分布很散。小A对重口或高强度描写不感兴趣,也不想在找文时反复踩雷。他在筛选栏里把“全年龄”和“轻微暗示”保留,把“限制级”和“警告向”排除。站内的分级标签比较细,除了大类还有“暴力描写”“心理压抑”等附加标记,他也一并排除。
排除之后,可读作品降到二十篇左右。小A没有急着全部打开,而是先看每篇的标签组合和简介前两行,确认没有自己明确不吃的元素,再决定是否加入书单。这样既不会因为分级误伤错过好作品,也不会因为点开才发现不对而浪费时间。
他特别提到,分级筛选要放在形式和标签交叉之后做,因为冷门CP的作品基数本来就小,如果一开始就排除太多,很容易把底本清空。先保证有足够候选,再按舒适区收窄,是更稳妥的顺序。
结果:二十篇可读作品与一条可复用的查找路径
最终小A锁定了二十篇左右的可读作品,其中短篇十四篇、已完结连载六篇,全部在全年龄或轻微暗示分级内。他按“先看短篇、再追连载”的顺序排了一个书单,两周内读完了大半,找到三篇特别合口味的,还顺带关注了两位同好作者。
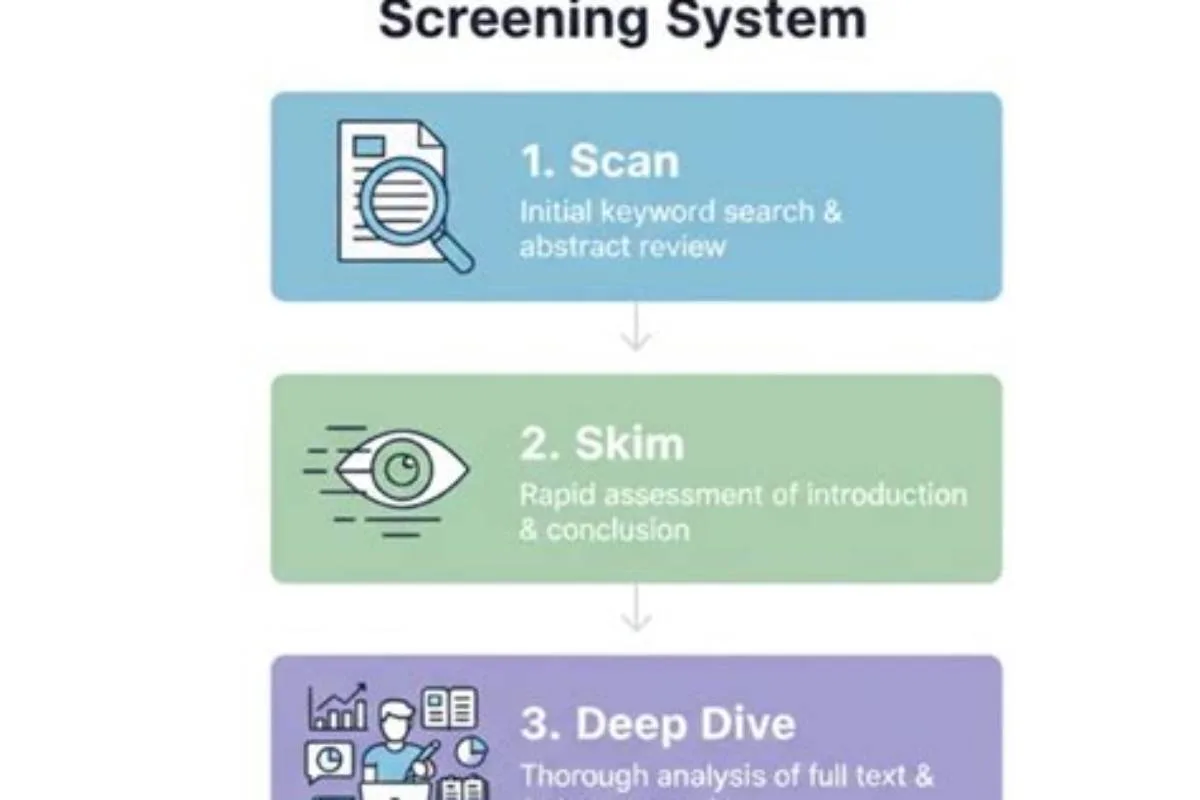
他把整个过程整理成一条路径:先确认原作标签和角色标签,用“原作+角色A+角色B”交叉锁定核心结果;再按形式筛掉未完结和碎片化条目;最后用分级和附加标记排除不感兴趣的内容。三步之后,冷门CP也能从“翻不到”变成“有得选”。
这条路径不依赖热门推荐,也不要求CP本身有足够热度,适合任何“角色有标签、组合没流量”的情况。小A的建议是:不要只搜CP名,先把原作圈子找对,再用标签一层层收窄,最后按自己的阅读习惯做减法。冷门CP的入口,往往就藏在这几个标签的交叉点上。